
发布时间:2026-09-05 14:55:06
阅读量:79564
分类:
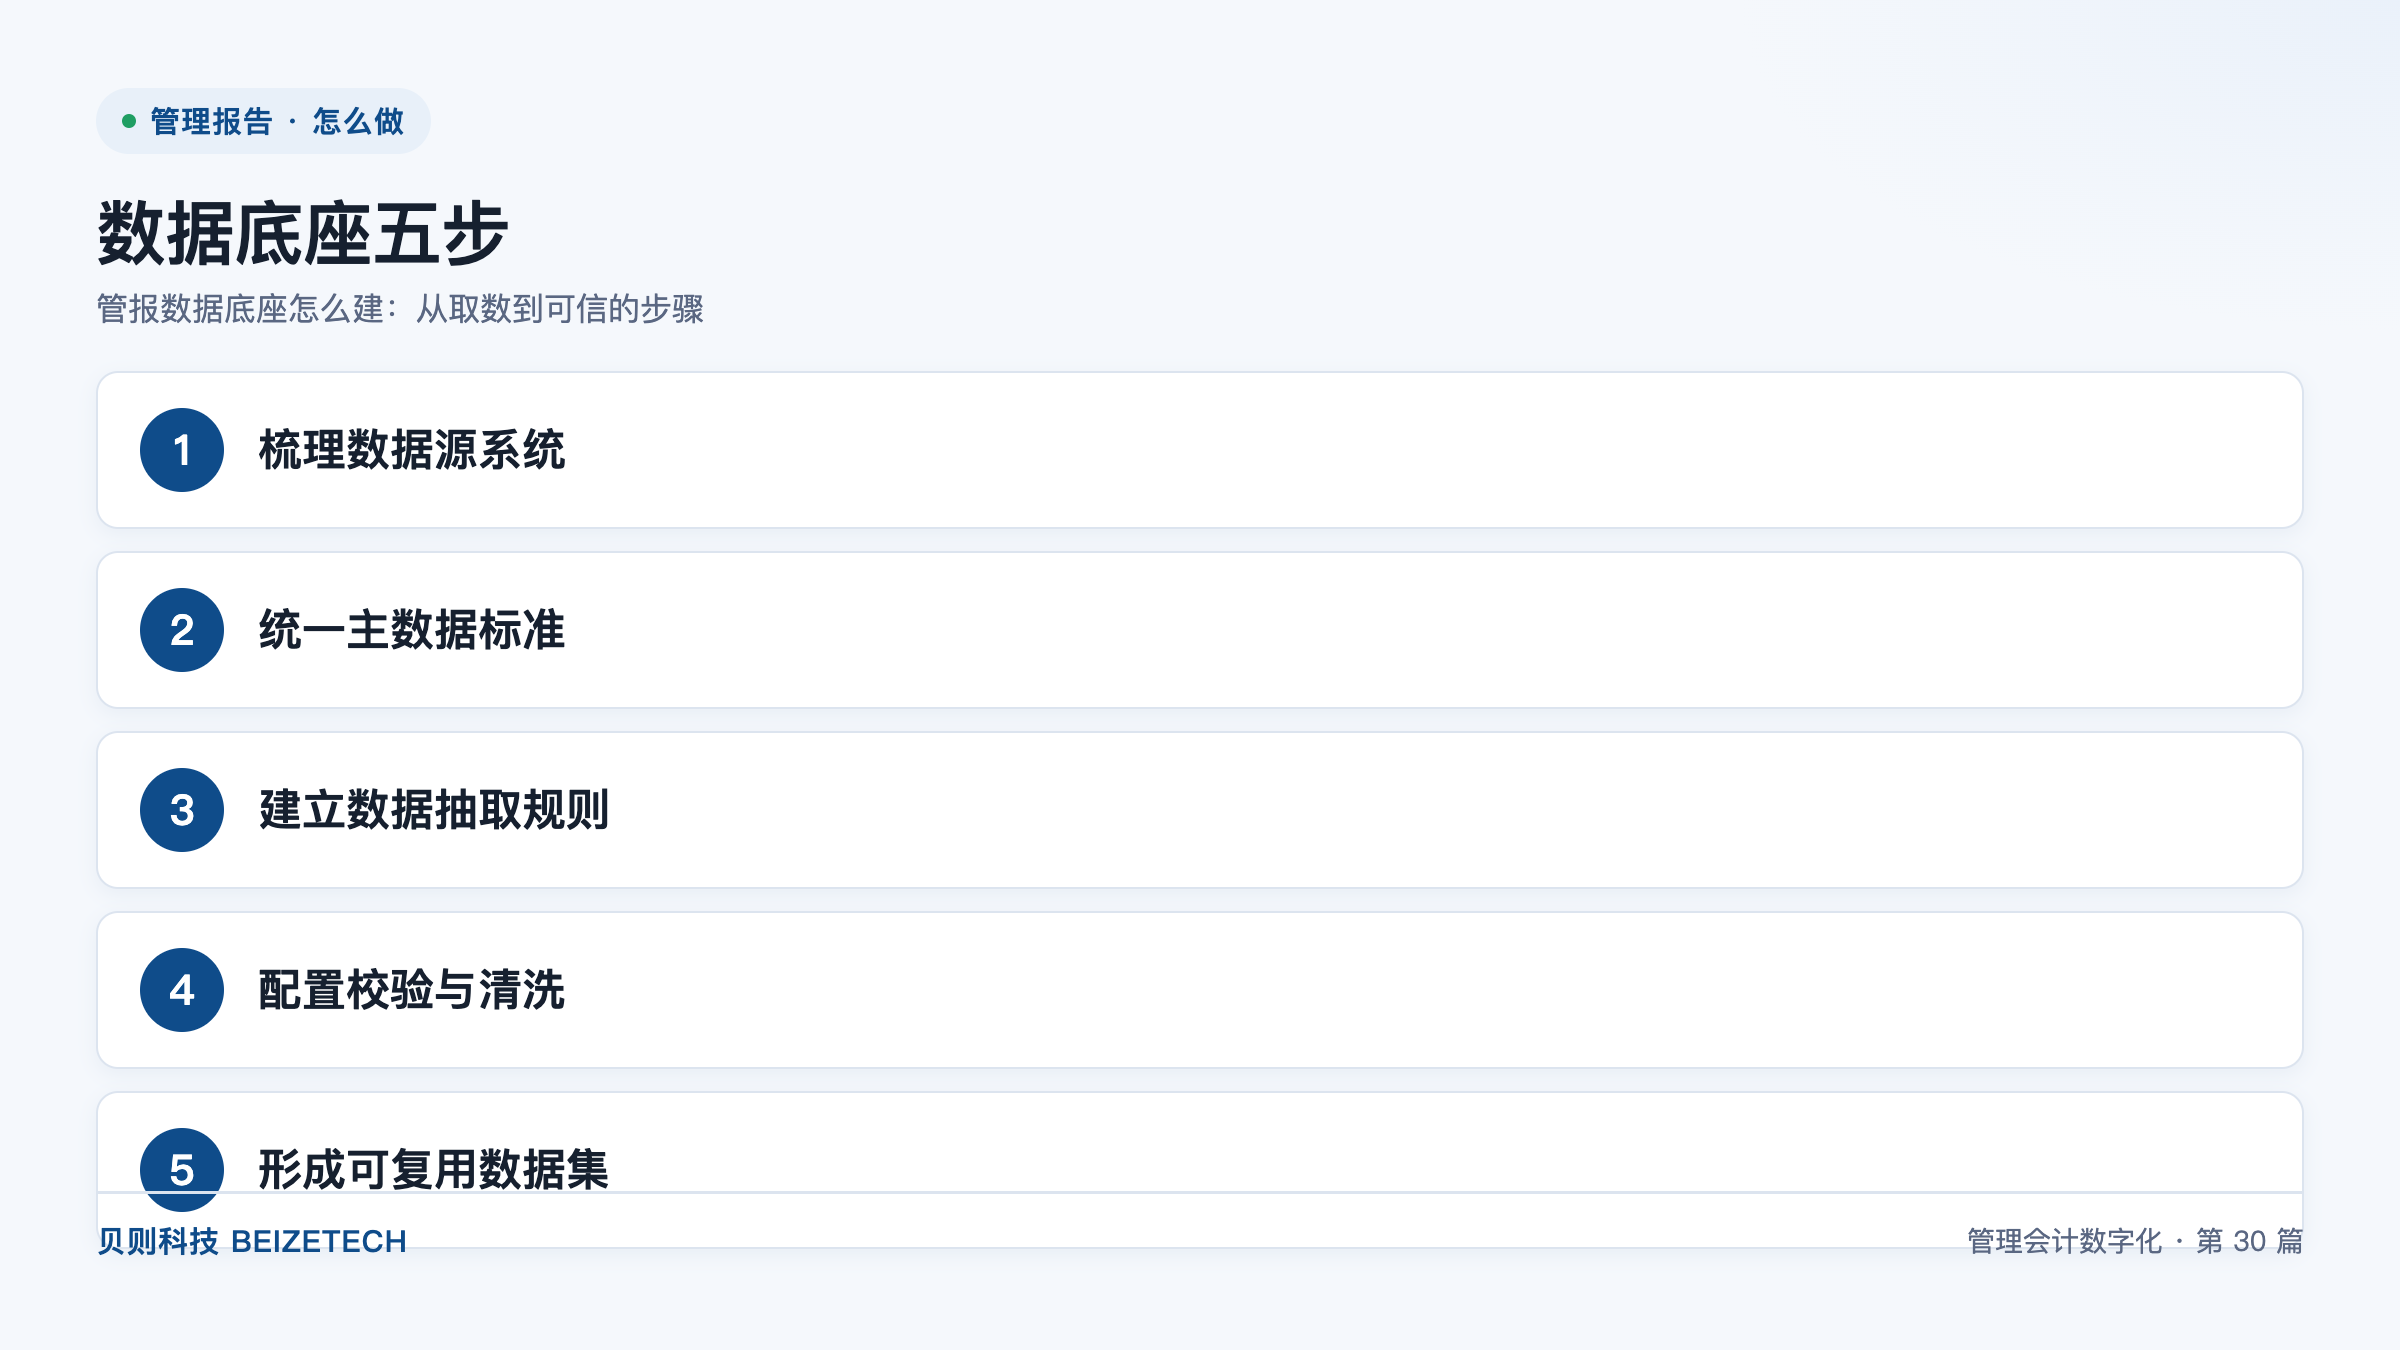
图:数据底座五步(贝则科技)
直接回答:管报数据底座按五步建设:梳理数据源系统、统一主数据标准、建立数据抽取规则、配置校验与清洗、形成可复用数据集。数据底座是指把分散在各业务系统的数据,按统一口径归集、清洗、校验后形成的可复用的数据集合。它是管报可信的前提——没有底座,大屏再漂亮也是"垃圾进、垃圾出"。按此建设,集团数据准确率可稳定在 99% 以上,月结周期典型可从 4–6 周压缩至 1–2 周。
管报数据底座是指按管报口径,把来自核算、销售、采购、生产、资金、人力等系统的数据,经过抽取、映射、清洗、校验后,形成的可复用、可追溯的数据集合。它有三个特征:口径统一(同一指标只有一个算法)、过程可追溯(每个数都能查到来源单据)、结果可复用(一次建设,支撑管报、预算、多维分析等多处使用)。
数据底座与数据仓的区别在于目的:通用数据仓追求"大而全",管报数据底座追求"准而稳"。底座里只放管报指标体系定义的那些数据,不放暂时用不上的数据——放进来的每一个字段,都要有对应的指标和责任人。
管理层说"这个数我不信",原因通常不是系统算错,而是以下三类根因之一。动手建底座前,先用这张表定位问题属于哪一类:
| 根因类型 | 典型表现 | 定位方法 |
|---|---|---|
| 口径不统一 | 同一指标财务与业务算出不同结果 | 抽取同一指标的两个来源比对,差异是否来自公式或过滤条件 |
| 主数据不一致 | 同一客户在不同系统有不同编码,收入无法按客户汇总 | 抽样比对组织、客户、产品编码在各系统间的对应关系 |
| 取数过程不可追溯 | 数字对不上时查不到来源单据 | 随机挑一个数,反向追到原始单据,看能否追通 |
三类根因的治理顺序不能颠倒:先统一主数据,再统一口径,最后解决追溯。主数据没对齐就先做报表,等于在沙滩上盖楼。
数据源梳理是指把管报所需数据的来源系统、模块、字段与更新频率全部登记在册。这一步的交付物是一张数据地图,按以下五步完成:
主数据是指跨系统共享的基础业务对象数据,包括组织、科目、客户、产品、供应商、币种、项目等。主数据不统一,同一客户在不同系统有不同编码,跨系统汇总就会重复或遗漏。统一按以下五步操作:
组织主数据尤其关键:管报按组织维度下钻,若集团架构调整后编码未同步,历史与当期数据就无法对比。建议组织主数据保留生效期间,支持按"当期架构"与"可比架构"两种口径查看。
数据抽取规则是指从源系统抓取数据的范围、条件与加工方式的完整定义。规则必须由指标字典驱动,按以下五步建立:
校验与清洗是指在数据进入底座前,自动检查并修正异常数据。校验规则按以下五类配置:
| 校验类型 | 检查内容 | 处理方式 |
|---|---|---|
| 完整性校验 | 必填字段是否为空、记录数是否异常波动 | 阻断并告警,提示补录 |
| 勾稽校验 | 资产 = 负债 + 权益,明细合计 = 总账 | 阻断,未平衡不允许进入下一环节 |
| 主数据校验 | 编码是否存在于标准主数据表 | 未匹配记录进入待处理池 |
| 口径校验 | 与指标字典定义的时间、组织口径是否一致 | 标记并通知口径责任人 |
| 波动校验 | 与上一周期相比波动是否超过阈值 | 不阻断,进入异常清单待人工确认 |
配置时遵循一条原则:能阻断的错误阻断,不能阻断的标记。把所有异常都设成阻断,任务会天天失败;全部放行,脏数据就会流进管报。建议对勾稽与主数据类错误设阻断,对波动类异常只做标记。
可复用数据集是指按管报口径组织好的、可直接被报表、多维分析模型、大屏调用的数据集合。形成数据集按以下四步操作:
| 步骤 | 核心交付物 | 主责方 | 配合方 |
|---|---|---|---|
| 梳理数据源系统 | 数据地图、来源系统清单 | 数据或 IT 团队 | 财务、各业务部门 |
| 统一主数据标准 | 主数据标准、编码映射表 | 主数据归口部门 | IT、各系统负责人 |
| 建立数据抽取规则 | 抽取规则说明书、调度任务 | 数据团队 | IT、系统供应商 |
| 配置校验与清洗 | 校验规则清单、异常待处理池 | 数据团队 | 财务、业务归口 |
| 形成可复用数据集 | 分层数据集、指标计算服务 | 数据团队 | 管报负责人 |
以一名贝则实施顾问的视角,数据底座是管报项目里最不"出彩"的环节——它不产生任何一张老板能看到的图,却决定了所有图的命运。我们进场后做的第一件事通常是看账、梳数据源、出场景清单,这属于 180 天落地四步法里的"调研做深";第二步"规则做实"则是把映射、折算、分摊规则一条条"焊"进系统。前两步做扎实,后面的"并行做足"和"移交做透"才顺。
贝则智瞰经营分析系统把数据底座搭建列为四大核心能力之一,与指标体系设计、多维分析建模、管理大屏可视化并列——四者是一根链条,底座断了,建模和大屏都无从谈起。从集团实践看,数据治理到位后,内部交易对账差异率典型可从 30%+ 收敛至 1–2%,数据准确率可稳定在 99% 以上,月结周期可从 4–6 周压缩至 1–2 周。这些结果的共同前提是:数据在进管报之前,已经被清洗和校验过一遍。
建数据底座,顺序不能反:先梳数据源,再统主数据,然后写抽取规则、配校验清洗,最后形成可复用数据集。跳过主数据直接做抽取,是最常见也最昂贵的返工来源。建议用"抽样追溯"作为验收的硬指标——随便挑一个数追不到单据,底座就不算建成。
建议收藏本文,或在评论区聊聊你们集团的数据现在卡在哪一步。了解更多管报数据底座建设方法,访问 beizetech.com。
A:三类:口径不统一(同一指标不同部门算法不同)、主数据不一致(同一客户在不同系统编码不同)、取数过程不可追溯(数字对不上时查不到来源单据)。其中主数据不统一是最底层的根因,必须先治理,否则口径统一无法实现。
A:五步——确定主数据范围(优先组织、产品、客户、区域)、制定不重复的编码规则、建立各系统编码与标准编码的映射表、指定每类主数据的归口部门、对历史存量做一次全量比对归并。组织主数据建议保留生效期间,支持按当期架构与可比架构两种口径查看。
A:取决于数据源数量与主数据基础。在贝则 180 天落地四步法中,数据底座贯穿"调研做深"与"规则做实"两个阶段,典型集团级项目从进场到客户独立出表约 6 个月。数据源越多、异构系统越复杂、主数据历史欠账越多,底座阶段占用的时间越长。
A:可以做演示,但不能作为交付路径。大屏上的每个数都来自底座,底座没建好时大屏只能靠人工填报或临时脚本支撑,数字不稳定、无法追溯,管理层看两次就会失去信任。建议顺序是先建底座再出大屏,或至少先完成核心指标的数据底座再上线对应的大屏模块。
A:按错误性质分级处理。勾稽类与主数据类错误设为阻断,必须修正后才能进入下一环节;波动类异常只做标记,进入异常清单由人工确认,不阻断任务。规则上线初期建议先只标记不阻断,运行 1–2 个周期摸清真实数据状况后,再逐步把稳定规则升级为阻断。
A:按分析用途决定。若只需同比,补 1–2 年;若要做趋势分析与预测,建议补 3 年。历史补录优先保证月度汇总数据可用,明细数据按需要逐步补充——历史明细的清洗成本远高于汇总层,且多数分析场景并不需要追溯到三年前的单据。
咨询热线
010-86463723
客服在线时间
9:00-18:00
(其他时间为机器人客服)



 京公网安备11010502056183号